
Introduction
Le Big Data désigne les volumes considérables d’informations générées et collectées par les organisations du monde entier, qu’il s’agisse de moteurs de recherche, de plateformes sociales ou de systèmes d’entreprise. La collecte de ces données est coûteuse et complexe, mais le véritable défi consiste à les analyser pour en extraire une valeur commerciale.
Le défi du Big Data
- Échelle : des milliards d’enregistrements, de fichiers multimédias et de journaux générés chaque jour.
- Infrastructure : nécessite des centres de données fonctionnant 24h/24 et 7j/7 avec du matériel et des logiciels avancés.
- Coût : les entreprises doivent justifier la dépense en transformant les données en informations exploitables.
Apache Hive : un entrepôt de données pour le Big Data
Apache Hive est un logiciel d’entrepôt de données open source qui :
- Facilite l’interrogation et la gestion de grands ensembles de données dans un stockage distribué
- Fonctionne sur Apache Hadoop, qui permet un traitement distribué sur des clusters
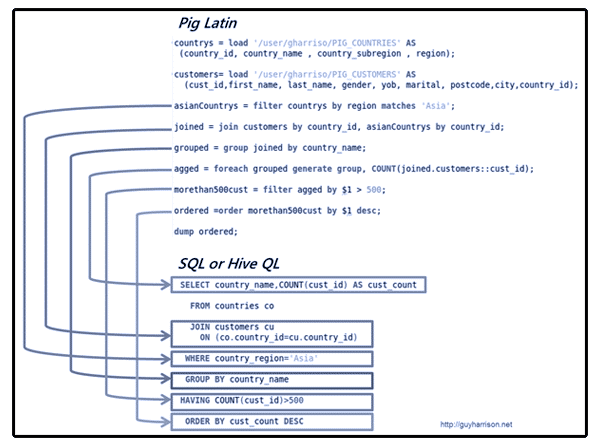
- Utilise HiveQL, un langage de type SQL, pour rendre les requêtes accessibles aux analystes
Comment Hive fonctionne avec Hadoop
- HDFS (Hadoop Distributed File System) : stocke d’immenses ensembles de données sur des clusters.
- MapReduce : traite des ensembles de données de plusieurs téraoctets en parallèle.
- Apache Pig : fournit une plateforme de plus haut niveau pour produire des programmes MapReduce.
- Compatibilité HBase : Hive peut également interroger des données stockées dans HBase et d’autres systèmes.
Ensemble, ces outils permettent aux organisations d’extraire, de transformer et d’analyser des données à grande échelle.
Pourquoi Hive est important pour les entreprises
- Évolutivité : commencez avec quelques serveurs et évoluez jusqu’à des milliers.
- Tolérance aux pannes : Hadoop détecte et gère les défaillances au niveau de la couche applicative.
- Accessibilité : les requêtes de type SQL facilitent l’analyse du Big Data pour les non-développeurs.
- Extraction de valeur : transforme les données brutes en informations qui orientent la prise de décision.
Considérations relatives à la mise en œuvre
Le déploiement de Hive et Hadoop nécessite :
- Une infrastructure informatique robuste (calcul, stockage et réseau)
- Des professionnels qualifiés pour configurer et maintenir les clusters
- Une planification rigoureuse pour aligner l’analyse de données sur les objectifs commerciaux
Conclusion
Apache Hive, associé à Hadoop et aux outils connexes, rend l’analyse du Big Data concrète et performante. Avec l’infrastructure et l’expertise adéquates, les organisations peuvent transformer d’immenses ensembles de données en informations pertinentes qui favorisent la croissance et l’innovation.